
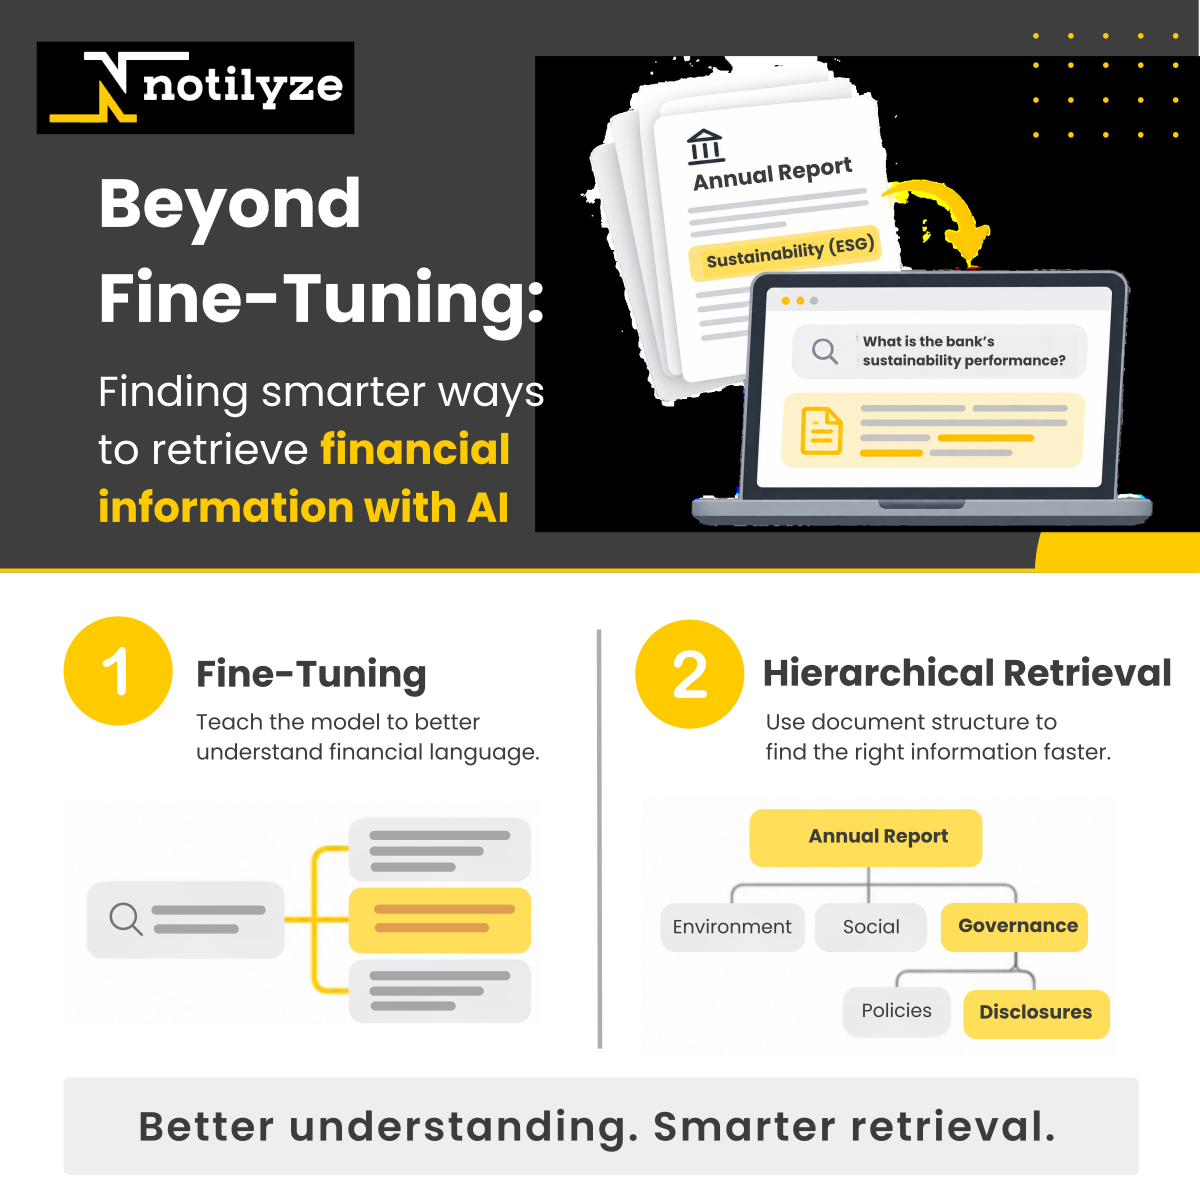
//Verder dan fine-tuning: slimmere manieren vinden om financiële informatie op te halen met AI
Van het trainen van betere embeddingmodellen tot het doorzoeken van complexe documenten: twee opeenvolgende onderzoeksprojecten bij Notilyze onderzochten hoe financiële AI-systemen nauwkeuriger en efficiënter kunnen worden gemaakt.
De uitdaging: De juiste informatie vinden
Stel je voor dat je een AI-assistent een vraag stelt over de duurzaamheidsprestaties van een bank. Het antwoord staat misschien ergens verborgen in een jaarverslag van 300 pagina’s, tussen informatie over milieurisico’s, corporate governance of duurzaamheidsrapportages. Verschillende banken kunnen zelfs uiteenlopende termen gebruiken om hetzelfde onderwerp te beschrijven.
Sinds 2024 verplicht de Europese Corporate Sustainability Reporting Directive (CSRD) bedrijven die onder de richtlijn vallen geleidelijk om informatie openbaar te maken over hun impact op het gebied van milieu, maatschappij en bestuur (ESG). Deze rapportages volgen de European Sustainability Reporting Standards (ESRS). Omdat deze standaarden relatief nieuw zijn, kunnen de rapportagepraktijken en de gebruikte terminologie per bank verschillen. Dezelfde rapportageverplichting kan op verschillende plekken in uitgebreide jaarverslagen terugkomen. Dit maakt het lastig om de juiste informatie te vinden en beperkt de beschikbaarheid van consistente trainingsdata.
Voor AI is het vinden van de juiste informatie vaak moeilijker dan het formuleren van het antwoord zelf. Hier komt Retrieval-Augmented Generation (RAG) om de hoek kijken. Met RAG kunnen Large Language Models (LLM’s) informatie uit externe documenten ophalen voordat ze een antwoord genereren, in plaats van uitsluitend te vertrouwen op hun trainingsdata. RAG brengt echter een belangrijke afhankelijkheid met zich mee: de kwaliteit van het antwoord hangt sterk af van de kwaliteit van de opgehaalde informatie.
Bij Notilyze onderzochten twee opeenvolgende onderzoeksprojecten hoe dit cruciale onderdeel van RAG-systemen verbeterd kan worden. Elk project benaderde het probleem vanuit een ander perspectief.
Stap 1: Het model financiële taal leren begrijpen
Het eerste project, uitgevoerd door Douwe Terlouw en Joep Bom, richtte zich op het fine-tunen van embeddingmodellen voor het gericht ophalen van financiële informatie (dense retrieval).
Bij dense retrieval worden embeddingmodellen gebruikt om vragen en tekstpassages uit documenten om te zetten in numerieke vectoren. Vervolgens worden relevante tekstpassages geïdentificeerd op basis van semantische overeenkomsten, in plaats van exacte overeenkomsten tussen zoekwoorden. Dit is bijzonder nuttig in de financiële sector, waar hetzelfde concept op verschillende manieren kan worden omschreven.
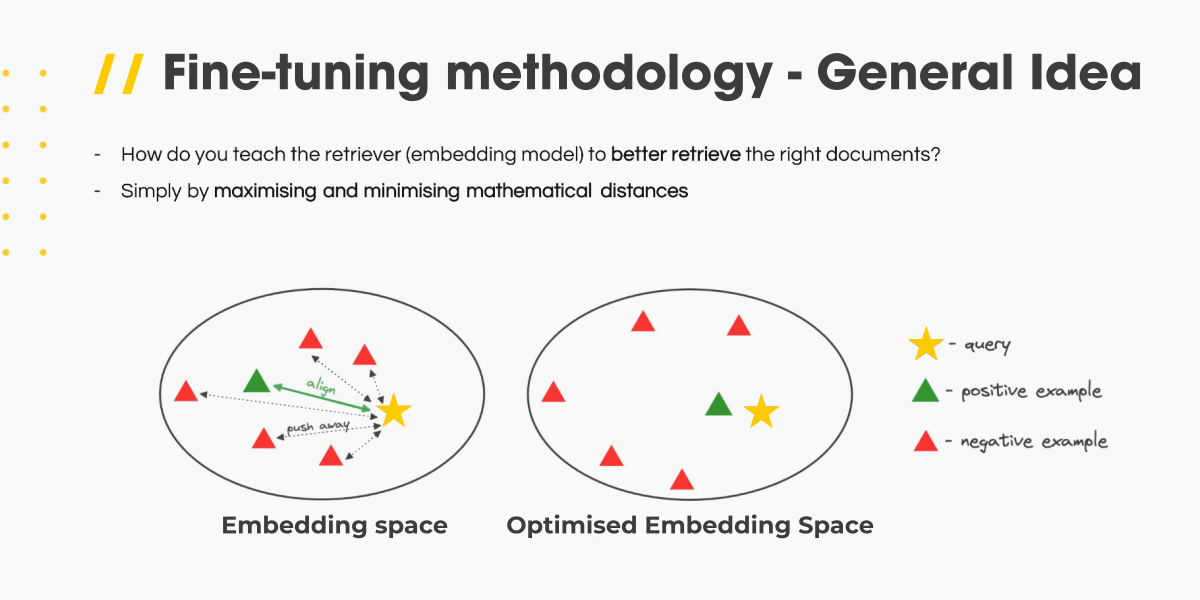
Algemene embeddingmodellen herkennen gespecialiseerde financiële terminologie echter niet altijd goed. Om dit te verbeteren, hebben de onderzoekers embeddingmodellen gefinetuned met gegevens uit duurzaamheidsverslagen van Europese banken. De resultaten bevestigden dat domeinspecifieke fine-tuning de kwaliteit van het ophalen van relevante informatie verbetert.
De illustratie laat zien hoe relevante voorbeelden dichter bij een zoekvraag worden geplaatst, terwijl irrelevante voorbeelden juist verder weg worden geplaatst.
Maar dit riep een nieuwe vraag op: wat als het probleem niet alleen ligt bij hoe goed het model de tekst begrijpt, maar ook bij de manier waarop documenten worden doorzocht?
Stap 2: Verbeteren hoe het systeem zoekt
Deze vraag stond centraal in het volgende onderzoeksproject van Bente Verhoef en Noortje Peters.
Fine-tuning helpt een model om relevante informatie beter te herkennen. Maar financiële documenten brengen nog een andere uitdaging met zich mee: hun structuur.
Traditionele dense retrieval doorzoekt doorgaans afzonderlijke tekstfragmenten. Jaarverslagen zijn echter opgebouwd uit hoofdstukken, secties en subsecties. Deze hiërarchie biedt waardevolle context over waar bepaalde informatie te vinden is. Een zoekmethode die rekening houdt met deze structuur, sluit beter aan bij de manier waarop mensen zelf door documenten navigeren.
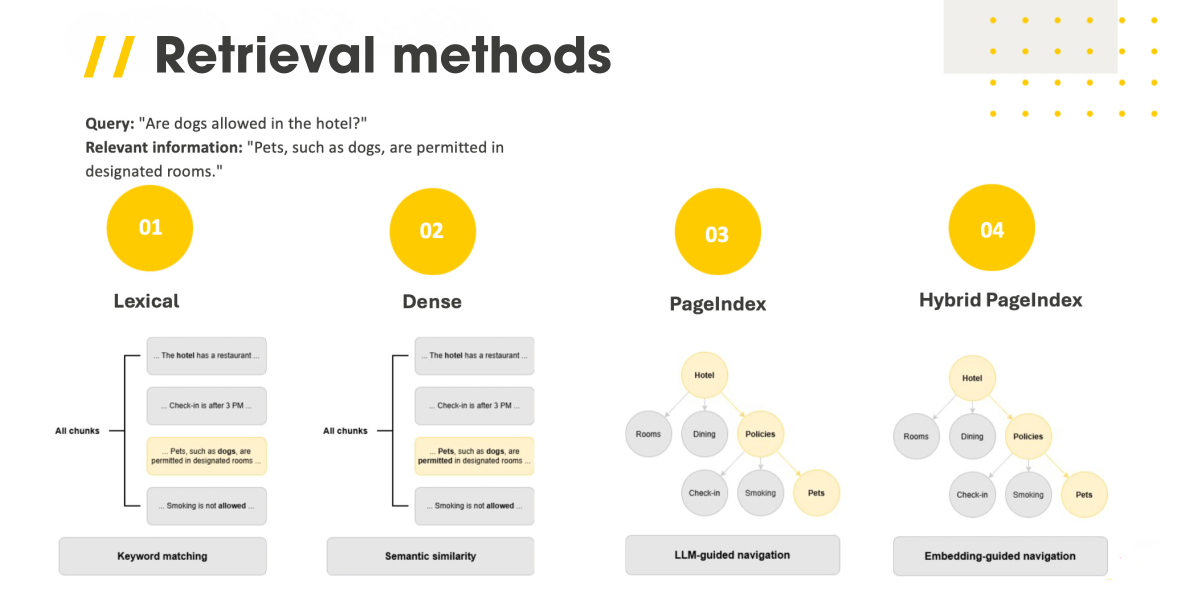
Bente onderzocht of het meenemen van de documenthiërarchie de kwaliteit van het ophalen van relevante informatie verder kon verbeteren. Hiervoor vergeleek ze dense retrieval met PageIndex, een systeem dat documenten organiseert in hiërarchische boomstructuren. PageIndex gebruikt een Large Language Model (LLM) om door deze structuur te navigeren en de secties te identificeren waarin het antwoord waarschijnlijk te vinden is.
Daarnaast ontwikkelde Bente Hybrid PageIndex, een methode die hiërarchische documentnavigatie combineert met semantische embeddings. In plaats van een LLM herhaaldelijk te laten bepalen welke vertakking moet worden onderzocht, gebruikt deze hybride aanpak semantische overeenkomsten tussen embeddings om het zoekproces te sturen.
Het doel was om de voordelen van de documentstructuur te behouden en tegelijkertijd de kosten van LLM-gestuurde navigatie te verlagen.
Wat heeft het onderzoek opgeleverd?
Bente evalueerde de verschillende methoden aan de hand van twee datasets: duurzaamheidsrapportages van 23 Europese banken en FinanceBench, een benchmark voor het beantwoorden van financiële vragen.
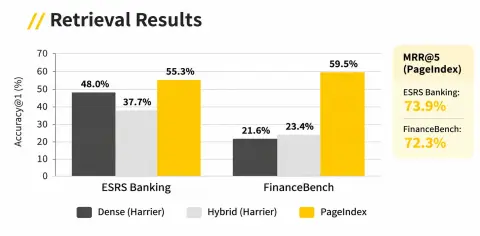
De resultaten lieten een belangrijke afweging zien tussen nauwkeurigheid en snelheid. PageIndex behaalde op beide datasets de hoogste nauwkeurigheid bij het ophalen van relevante informatie. Op de dataset met duurzaamheidsrapportages van Europese banken behaalde PageIndex een score van 73,9% op de retrieval-rankingmaatstaf (MRR@5). Dit betekent dat relevante informatie doorgaans hoog in de zoekresultaten werd geplaatst. Deze prestaties hadden echter een keerzijde: PageIndex moest herhaaldelijk een LLM inzetten om te redeneren over de documentstructuur, wat resulteerde in aanzienlijk langere verwerkingstijden per zoekopdracht.
Hybrid PageIndex bood een andere balans tussen snelheid en nauwkeurigheid. De methode was aanzienlijk sneller dan PageIndex en presteerde op FinanceBench beter dan de overeenkomstige dense-retrievalmodellen. Op de dataset met duurzaamheidsrapportages van Europese banken presteerde de hybride aanpak echter minder goed dan traditionele dense retrieval zonder hiërarchische documentstructuur.
Dit leidde tot een belangrijke conclusie: het toevoegen van documentstructuur zorgt niet automatisch voor betere zoekresultaten. De manier waarop een systeem door die structuur navigeert, is minstens zo belangrijk.
Betere nauwkeurigheid of hogere efficiëntie?
Het onderzoek liet ook zien waarom de prestaties van een zoeksysteem niet alleen op basis van nauwkeurigheid kunnen worden beoordeeld. PageIndex leverde de beste resultaten op, maar de LLM-gestuurde zoekmethode vereiste aanzienlijk meer tijd en rekenkracht. Dense retrieval en Hybrid PageIndex boden daarentegen veel kortere verwerkingstijden per zoekopdracht.
Voor organisaties die AI op grote schaal inzetten, is dit verschil belangrijk. Een systeem dat wordt gebruikt voor financiële analyses waarbij veel op het spel staat, kan prioriteit geven aan nauwkeurigheid. Een applicatie die grote aantallen zoekopdrachten verwerkt, heeft daarentegen mogelijk meer behoefte aan snelle responstijden.
Twee benaderingen, één belangrijke les
Samen laten deze onderzoeksprojecten twee complementaire manieren zien om financiële AI te verbeteren. Fine-tuning verbetert het vermogen van een model om relevante informatie te herkennen. Hiërarchische retrieval verbetert de manier waarop een systeem deze informatie organiseert en doorzoekt.
Geen van beide benaderingen biedt een universele oplossing. De resultaten laten zien dat het gebruik van documentstructuur aanzienlijke verbeteringen kan opleveren, maar dat de effectiviteit afhangt van de data en de gekozen zoekstrategie. Het combineren van embeddings met een hiërarchische structuur kan voordelen bieden, maar garandeert niet automatisch betere prestaties.
Voor organisaties die werken met complexe financiële documenten gaat de belangrijkste les verder dan de keuze voor een specifieke technologie. Het ontwikkelen van betrouwbare AI draait niet alleen om het slimmer maken van modellen, maar ook om het ontwerpen van betere manieren waarop deze modellen de informatie kunnen vinden die ze nodig hebben.
*Dit onderzoek richtte zich specifiek op de financiële sector. De onderzochte methoden kunnen echter ook worden toegepast in andere sectoren waarin gespecialiseerde vakterminologie wordt gebruikt. Door het RAG-systeem aan te passen aan een ander vakgebied, kan het ook daar worden ingezet. Het uiteindelijke doel is namelijk om de prestaties van RAG-systemen te verbeteren, voorbij de beperkingen van hun oorspronkelijke trainingsdata en standaardinstellingen.
Dit artikel is gebaseerd op de onderzoeksprojecten “Fine-Tuning of Embedding Models to Improve Retrieval-Augmented Generation Systems” van Douwe Terlouw en Joep Bom (2026) en “Combining Hierarchical Structure and Semantic Retrieval in Financial RAG Systems” van Bente Verhoef en Noortje Peters (2026), Erasmus Universiteit Rotterdam.
Over Notilyze
Wij zijn Notilyze, een SAS®-partner met één doel: organisaties helpen met data-analyse en hen meer datagedreven en succesvoller maken. Ons doel is om data-analyse toegankelijk te maken voor elke afdeling en elk bedrijf. Dit doen wij door SAS® as a Service aan te bieden. Notilyze Cloud is de snelste oplossing om te starten met AI op SAS® Viya®. Daarnaast bieden wij IT-oplossingen om analytics goed te integreren in bestaande processen, evenals de expertise van onze SAS®-specialisten.
// Contact
Notilyze B.V.
Stationsplein 45 A4.004
3013 AK Rotterdam
+31 (0)10 79 86 295
info@notilyze.com

